07.11.2026 Cómo funciona Gramola.Link por dentro [proyectos, gramola]
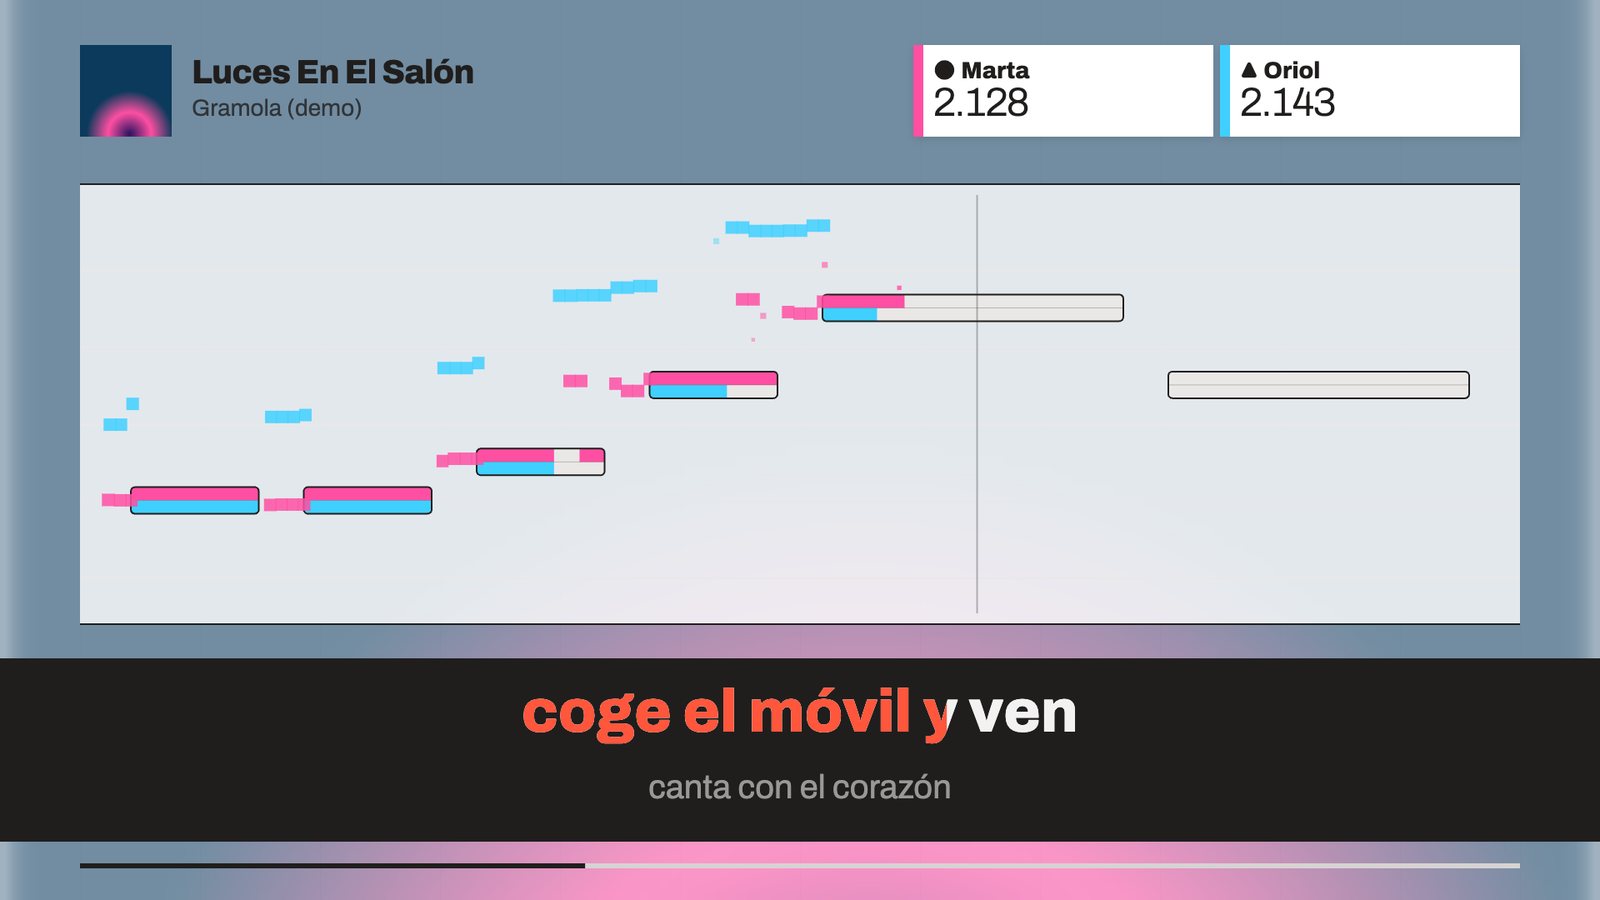
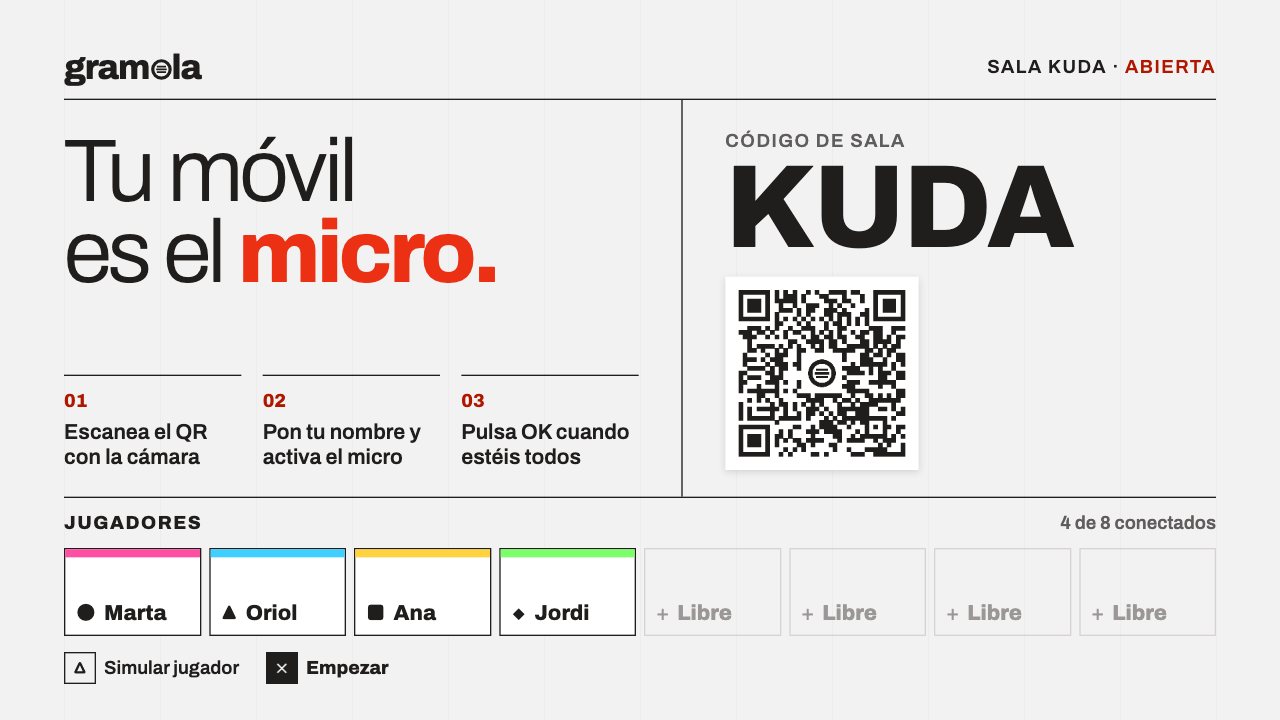
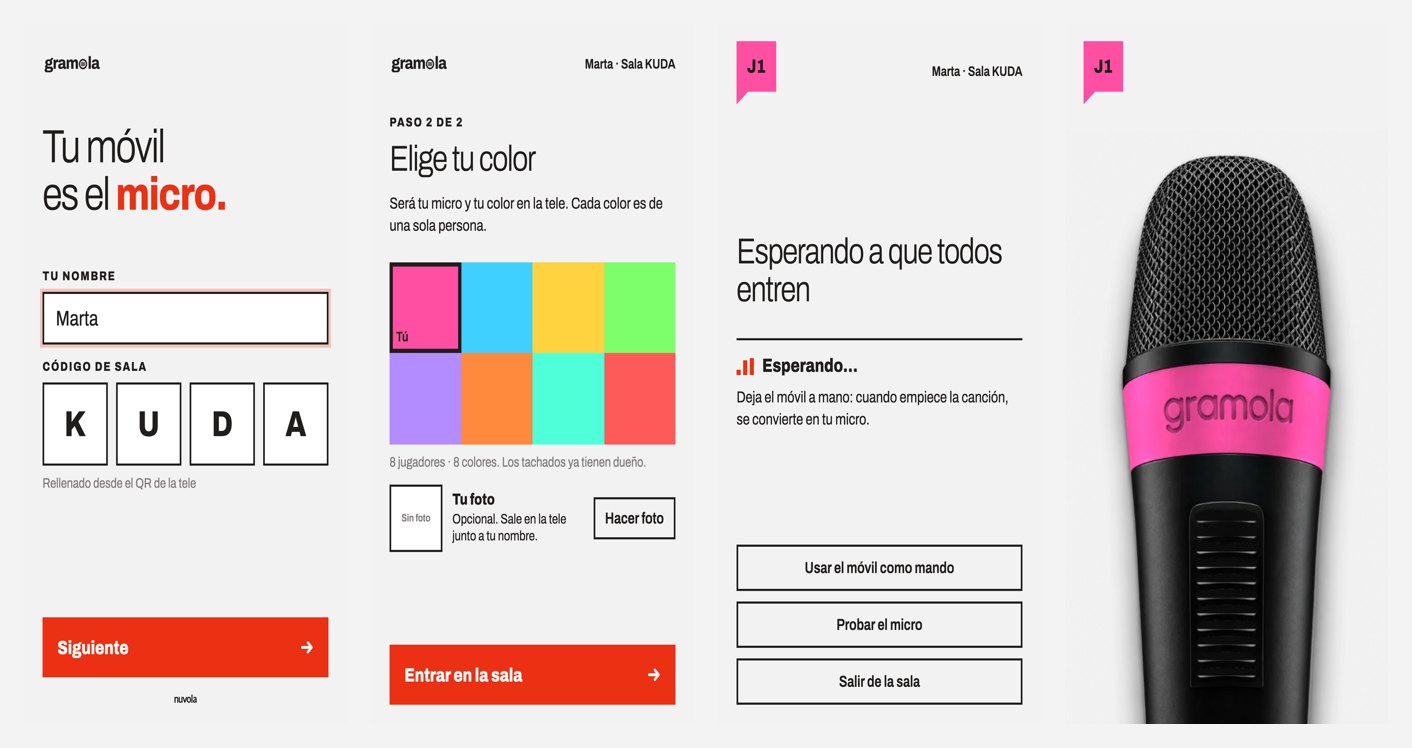
Gramola es un karaoke para jugar en casa. La tele es el escenario y funciona en el navegador (o como app en una tele LG); cada móvil es un micrófono: escaneas el QR, eliges tu color y cantas. Gramola escucha el tono de cada voz y puntúa lo afinado que vas. Hasta ocho personas a la vez, cada una con su estela y su marcador.
El código es abierto (licencia MIT) y está en GitHub: github.com/nuvolacat/Gramola.link. En este post cuento cómo está hecho: la arquitectura, cómo son las canciones, cómo se sincroniza el micro del móvil con lo que suena en la tele, cómo se puntúa y cómo funciona el editor de canciones.
Tres piezas
 Móviles (web, PWA)  ──WebSocket──►  Servidor de salas (Node.js)  ◄──WebSocket──  Tele (navegador)
micro + YIN /ws · /api/songs · /api/records diseño + puente- El servidor es un Node.js con una sola dependencia (
ws). Gestiona las salas, reenvía la voz de cada móvil a su tele, sirve las canciones y guarda los récords. Una sala es un código de cuatro letras (consonante-vocal-consonante-vocal, tipo «MOKA», sin palabras feas) y su QR. - La tele es una página web a pantalla completa. Tiene todas las pantallas: bienvenida, sala, menú, lista de canciones, canto, resultados, ajustes.
- El móvil es otra página web instalable como PWA. Hace una sola cosa: capturar el micro, calcular el tono y mandarlo al servidor.
Cada aparato abre una conexión WebSocket a /ws y todo son mensajes JSON con un campo type. La tele manda host para abrir sala; el móvil manda join con el código y el color elegido; el servidor devuelve a la tele la lista de jugadores y, mientras se canta, los mensajes pitch de cada uno. Si la tele se recarga o se corta la red recupera su sala con un token, y lo mismo el móvil. Al parar el servidor para desplegar, las salas se guardan en disco y se restauran al arrancar.
El diseño es la tele
La interfaz de la tele no está programada «a mano» pantalla por pantalla. El punto de partida es un prototipo interactivo del diseño (React), que ya trae todas las pantallas, transiciones, el mando y la pantalla de canto con datos simulados. Un script (tools/build-tv.py) copia ese prototipo e inserta unos 120 enganches cortos que llaman al puente (web/tv/gramola-bridge.js): las constantes simuladas pasan a ser arrays con datos reales, buildChart() lee la partitura de la canción elegida, update(dt) usa el reloj del audio y la voz real de cada móvil, el QR y el código son los de la sala de verdad.
Así la tele queda idéntica al diseño por construcción. Si llega una versión nueva del diseño, se vuelve a ejecutar el script y queda conectada; si algún trozo ha cambiado y un enganche ya no encaja, el script se para y dice cuál.
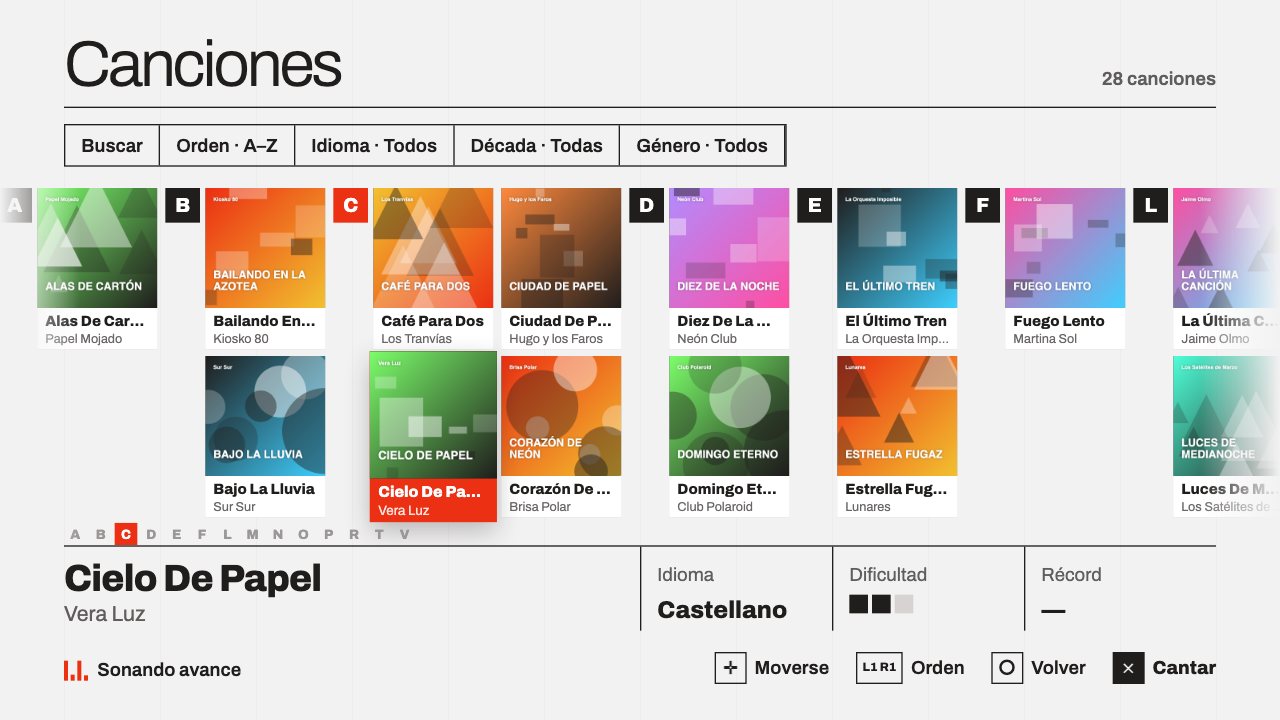
El puente añade lo que el prototipo no tenía: la rejilla de canciones agrupada por inicial con avances de audio, el Megamix, la portada difuminada de fondo, la barra de aproximación que llega a la letra justo cuando hay que cantar, el detector de vibrato, los sonidos de menú, la calibración del micro y el soporte de mandos.
Modos y mando
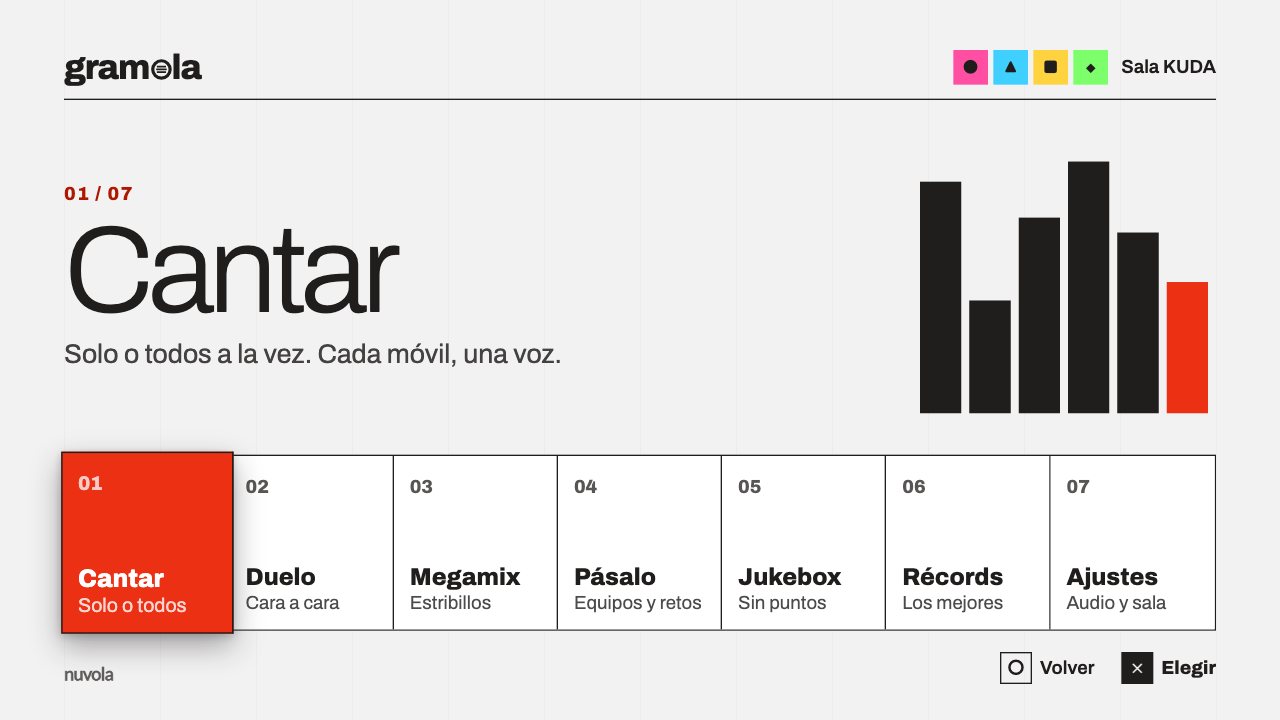
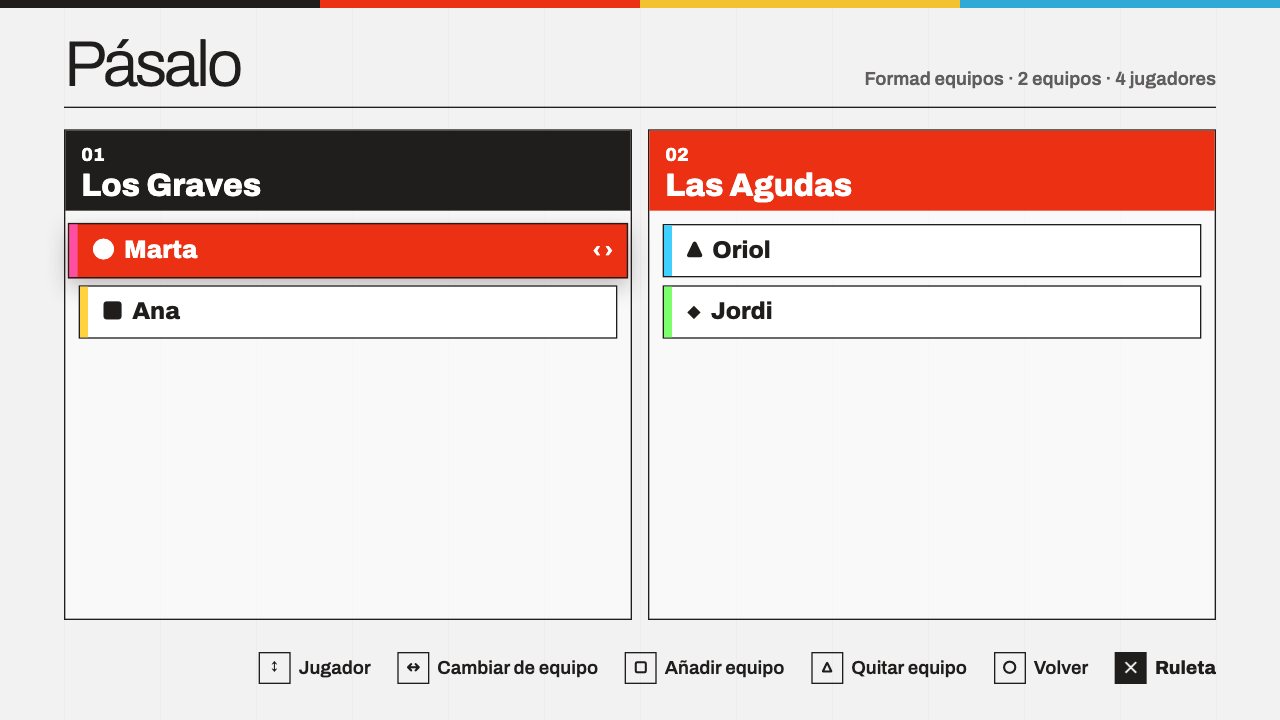
Además de cantar solo o todos a la vez, hay Duelo (dos jugadores o dos equipos con barra de tira y afloja), Megamix (el estribillo de 4, 6 u 8 canciones al azar sin repetir artista, encadenadas con fundido cruzado), Pásalo (equipos, ruleta de retos y turnos), Jukebox (la letra en grande y sin puntos, con cola automática) y Récords (salón de la fama por canción y por cantante).
Se maneja con un mando de PlayStation por Gamepad API, con el mando de la tele LG (la cruceta llega como teclas y el botón Atrás es el código 461) o con el ratón en un ordenador. Las ayudas en pantalla cambian según lo que detecta: símbolos de PlayStation si hay un mando conectado, puntos de colores si es el mando de la tele.
En la LG, Gramola es una app webOS mínima que abre la web a pantalla completa. Chromium 108 por dentro, con una limitación importante: solo reproduce un <audio> a la vez. Por eso los avances de la lista de canciones y el Megamix van por Web Audio: se descarga por rangos solo el trozo del MP3 que hace falta (la posición se calcula con la cabecera MP3/Xing), se decodifica y suena con fundido cruzado.
Las canciones: formato UltraStar
Gramola lee el formato de texto UltraStar, abierto y muy extendido. Cada canción es una carpeta con un .txt, el audio y una portada. El .txt tiene cabeceras y una línea por nota:
#TITLE:Luces en el salón
#ARTIST:Gramola (demo)
#BPM:240
#GAP:4000
#MP3:demo.mp3
: 0 3 4 Lu          normal: inicio, duración, tono, sílaba
: 4 3 4 ces
* 96 7 9 no         dorada (vale doble)
F 120 4 0 ¡ey!      libre (no puntúa)
- 32                salto de frase
E                   fin
Los tiempos van en pulsos: un pulso dura 60000 / (BPM × 4) ms, y #GAP son los milisegundos desde el inicio del audio hasta el pulso 0. El tono 0 es Do4 (MIDI 60) y cada unidad es un semitono. Un detalle que da muchos disgustos: los espacios al final de las sílabas cuentan, porque son lo que separa una palabra de la siguiente.
El lector (web/js/ultrastar.js) convierte todo eso a milisegundos y lo usan tanto la tele como el servidor. Detecta solo la codificación (UTF-8 o Windows-1252), entiende el formato antiguo relativo y los dúos (P1/P2).
Las canciones no están en el repositorio. Para añadir un lote hay una cadena de herramientas en Python:
| Paso | Qué hace |
|---|---|
preparar-canciones.py | Nombres en Unicode NFC, .txt a UTF-8, cabeceras apuntando a los ficheros que existen, saca el audio del vídeo si no hay MP3, convierte lo que no es MP3 de verdad y recorta el tramo del Megamix. |
normalizar.py | Iguala el volumen a −12 LUFS (EBU R128, loudnorm en dos pasadas, picos a −1 dBTP) en las que se alejan más de 1,5 dB. |
caratulas.py | Busca portadas de más calidad y deja una página para revisarlas antes de aplicarlas. |
megamix.py | El estribillo sale de #MEDLEYSTARTBEAT / #MEDLEYENDBEAT si existen; si no, del bloque de frases repetido más largo (acierta en unas 8 de cada 10). |
En la tele los títulos se muestran limpios: sin lo que va entre paréntesis y con mayúscula en cada palabra. Los ficheros no se tocan.
El micro: el móvil calcula el tono
Lo primero que decidí es que el tono se calcula en el propio móvil y no en el servidor ni en la tele. Mandar audio por WebSocket desde ocho móviles sería mucho ancho de banda y mucha latencia; en cambio, una nota y un volumen son unos pocos bytes, 25 veces por segundo.
El micro se abre con getUserMedia sin cancelación de eco ni supresión de ruido: los dos estropean el tono. La ganancia automática sí, porque sin ella el iPhone entrega la voz muy floja. Y siempre el micrófono del propio móvil: si el sistema ofrece unos AirPods o unos cascos Bluetooth, se busca el integrado, porque el micro de los auriculares va con mucho retraso y en otra sala.
El algoritmo es YIN sobre bloques de 2.048 muestras cada 40 ms, entre 70 y 1.100 Hz, con suelo de ruido adaptativo, claridad mínima 0,8 y mediana de tres lecturas. Hay un detalle propio para fiestas: la música de la tele entra por el micro, y con ruido no siempre hay un mínimo claro por debajo del umbral; en ese caso se toma el mínimo global si es razonablemente bueno y, entre candidatos parecidos, el periodo más corto, para no confundir la nota con un múltiplo. Al final, interpolación parabólica para afinar la frecuencia y conversión a nota MIDI decimal.
Cada 40 ms el móvil manda {n, v, lat}: nota, volumen y su latencia estimada. La pantalla no se apaga mientras se canta (Screen Wake Lock, con un vídeo mudo como plan B en móviles que no lo tienen), y si se cierra la app en segundo plano, al reabrirla vuelve a su sala con su color.
Sincronización: dónde cae cada muestra
Aquí está el problema de verdad. Entre que cantas y la tele recibe la nota pasan varias cosas: el bloque de 40 ms del YIN, la red del móvil al servidor, la red del servidor a la tele, y además el audio de la tele suena con retraso respecto a lo que el reloj del navegador cree.
Cada cliente mide su media latencia con pings: manda {type:"ping", t} y se queda con la mediana de 9 viajes de ida y vuelta, partida por dos. El móvil la incluye en cada muestra y la tele conoce la suya. Cuando llega una muestra, la tele no la pinta «ahora», sino que la coloca en el instante en que se cantó:
t = reloj_del_audio − (ajuste_del_micro + latencia_del_móvil + latencia_de_la_tele)El reloj de la partida es el del audio, no el del sistema. Sigue a currentTime suavizado (algunas teles lo actualizan a saltos) y le descuenta outputLatency y baseLatency del AudioContext, porque la música sale por los altavoces después de que el navegador crea que ha salido. Sin esto, en la LG la letra iba 170 ms por delante de lo que se oía.
El ajuste del micro cubre lo que no se puede medir: el retraso del propio micro del móvil y lo que tarda la persona en reaccionar. Se mide en Ajustes con una calibración: la tele hace ocho pitidos y tú dices «pa» con cada uno; la diferencia entre cuándo sonó el pitido y cuándo llegó el «pa» es el retraso.
Con todo esto la estela de cada voz se dibuja pegada a las notas aunque la red tarde, y la comparación con la nota se hace en el instante correcto.
Puntuación
Cada nota se parte en ranuras de 40 ms. Una ranura cuenta si en ella la voz está dentro del margen: ±4 semitonos en Fácil, ±2 en Normal y ±1 en Difícil (cada cantante elige el suyo). La octava es indiferente: se compara la nota, no lo grave o agudo que cantes. Hay 10.000 puntos repartidos entre todas las ranuras de la parte del cantante y las notas doradas valen el doble.
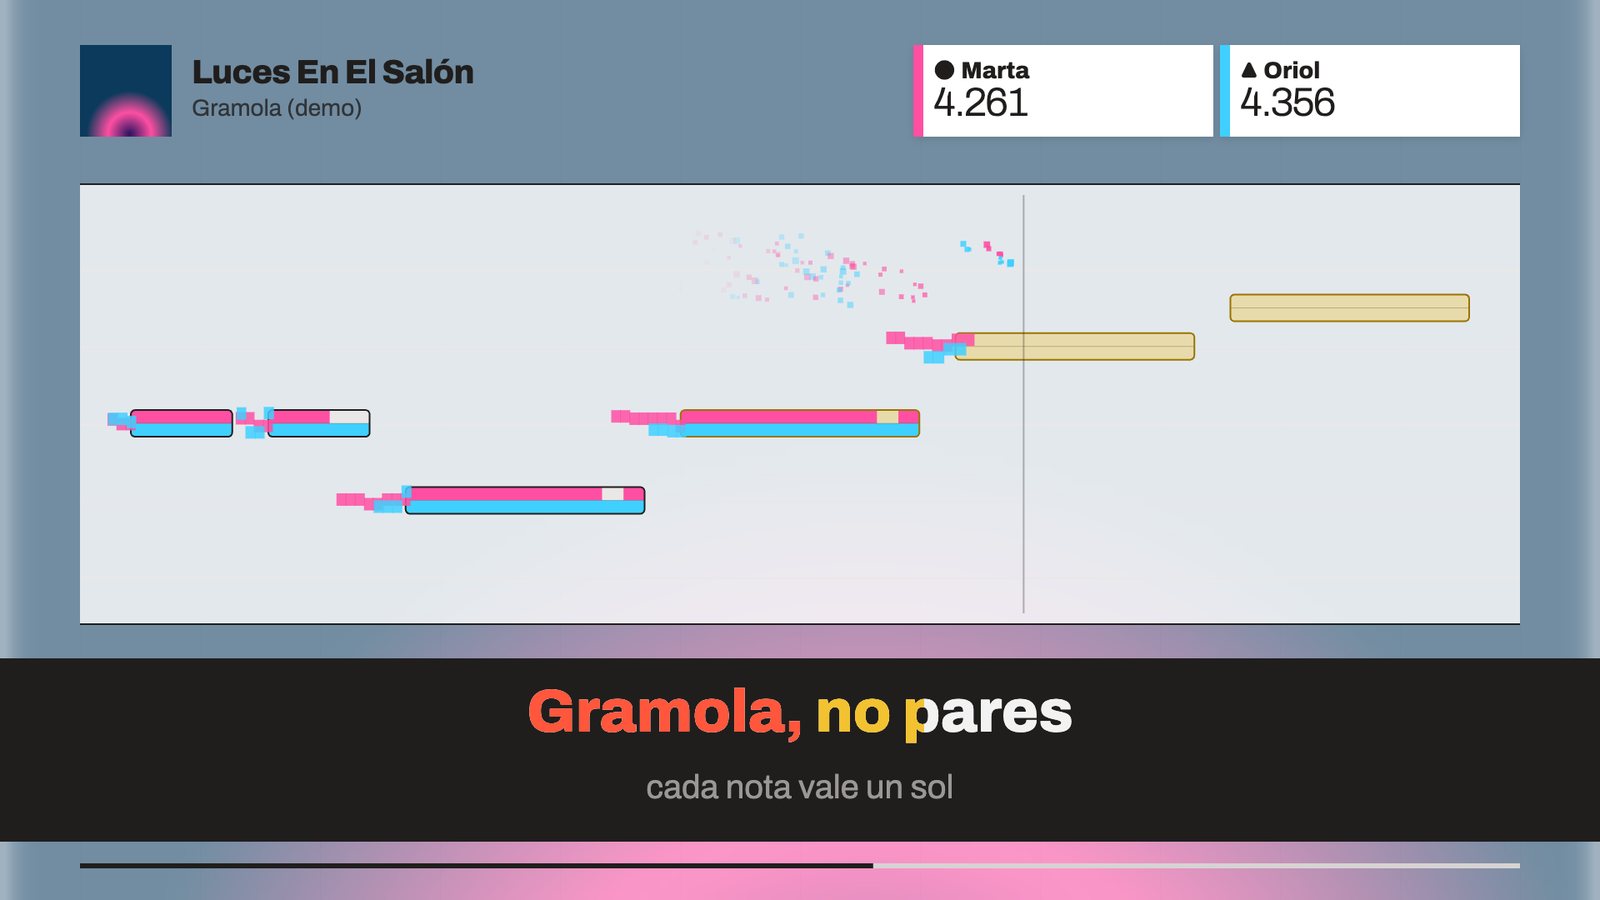
En las notas de 0,8 s o más hay un detector de vibrato: se guardan las lecturas que llegan del móvil y se busca una oscilación regular alrededor de la nota, entre 4 y 8,5 vaivenes por segundo y de 0,3 a 2,2 semitonos de pico a pico, quitando antes la tendencia para que un desliz lento no cuente. Se dibuja con ondas y purpurina y suma puntos extra. Al final sale la puntuación, la precisión, las doradas acertadas, la racha, la mejor frase y el rango, de Cantante de ducha a Mito.
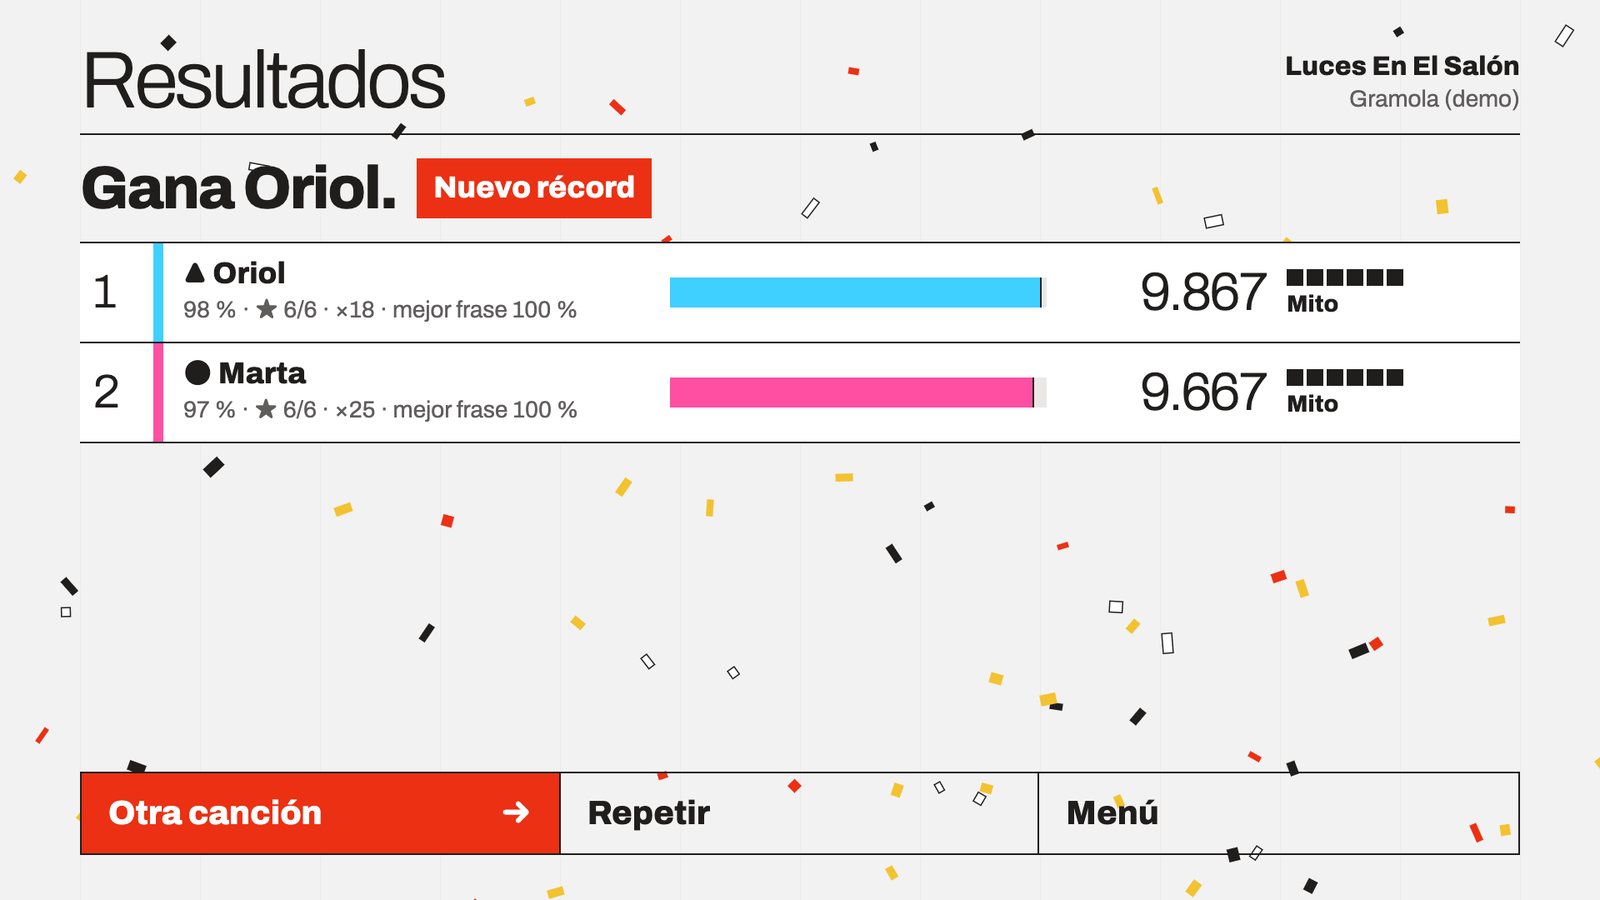
Los récords los comprueba el servidor. La tele puntúa y dibuja en directo, sin esperar a la red, pero el récord que se guarda lo calcula también el servidor (server/puntuacion.js), que ve pasar la misma voz que reenvía a la tele. Al empezar, la tele le manda qué canción es y el margen de cada cantante; cada segundo le manda en qué punto va el audio. El servidor lee la misma partitura con el mismo lector y aplica la misma regla. Al acabar, recorta los puntos de la tele a lo que él ha visto acertar (con un margen para el vibrato, que solo puntúa la tele) y descarta bots y jugadores que no han cantado. Un récord exige haber mandado una voz que acierte las notas durante toda la canción; no basta con una petición HTTP.
El editor de canciones
Las canciones se gestionan desde un panel de administración (entrada solo con Touch ID, por WebAuthn) que sirve el mismo servidor. Tiene salas en directo, estadísticas, récords y, lo más interesante, un editor que edita el mismo .txt que lee la tele.
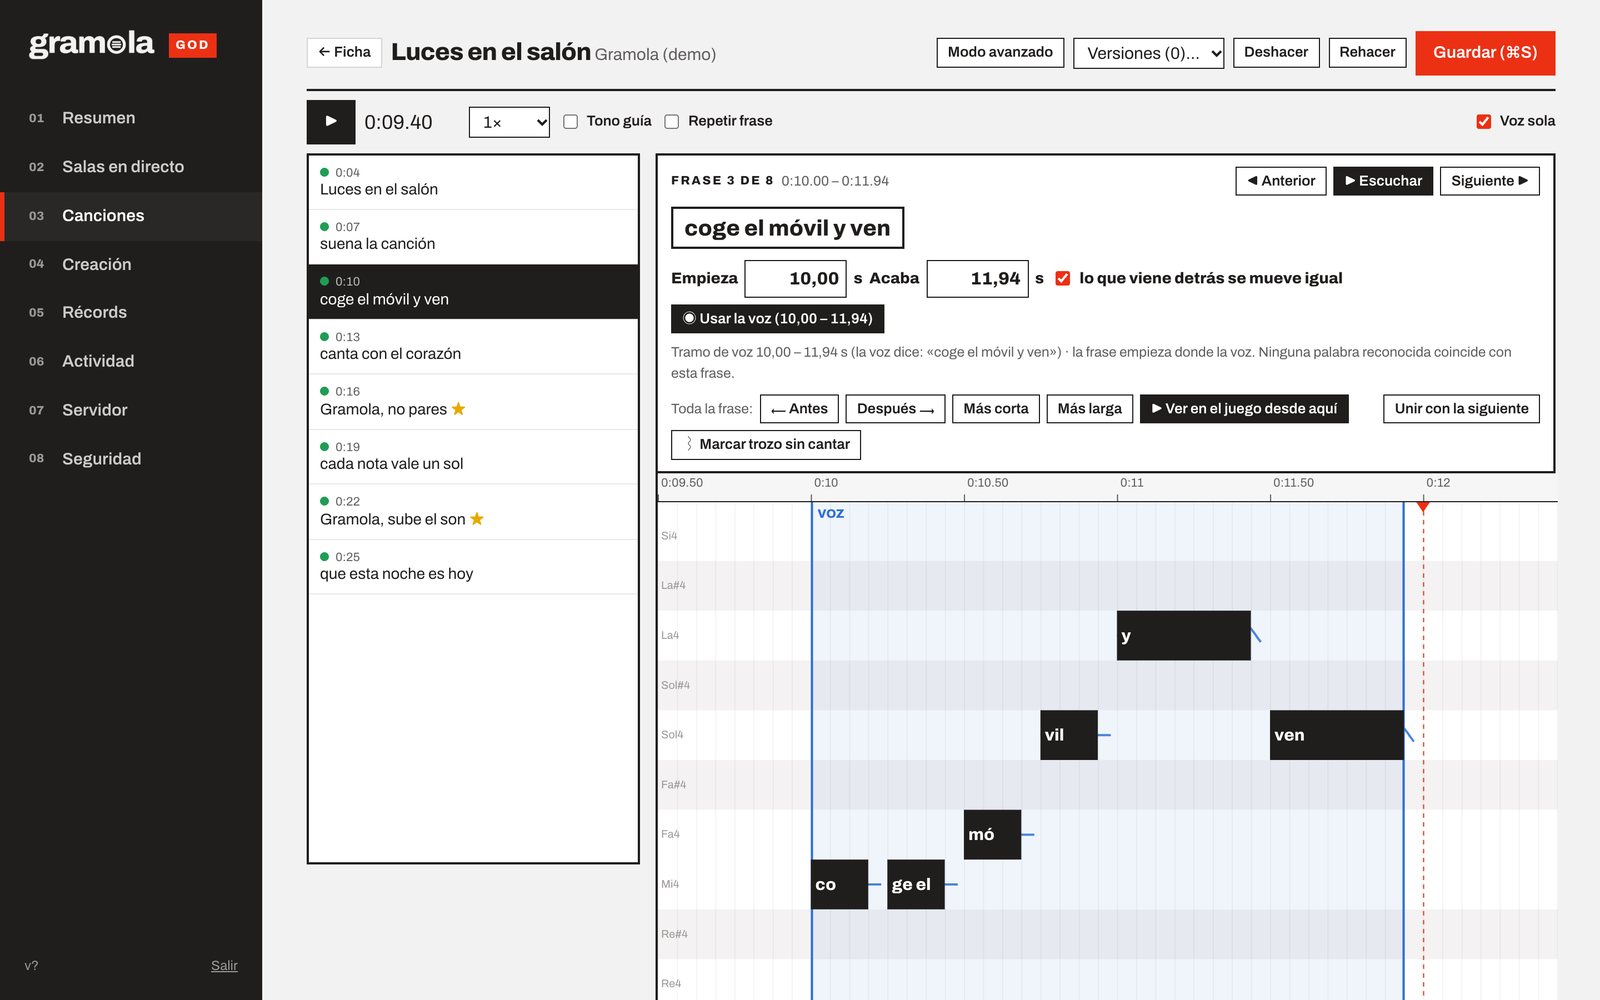
El modo por defecto trabaja por frases sobre la voz. A la izquierda, la lista de frases con un punto: verde si la frase empieza donde empieza la voz, amarillo si la voz empieza en otro sitio, hueco si no hay voz cerca. Al elegir una frase, en el lienzo solo se ve ella con su trozo de voz: la onda de la voz separada, lo que el reconocimiento dice que se canta ahí, y cada sílaba como un bloque a la altura de su nota sobre la curva del tono real.
Las dos casillas importantes son Empieza y Acaba, en segundos. Al cambiar «Empieza» la frase entera se desplaza; al cambiar «Acaba» sus sílabas se estiran o encogen en proporción. Con «lo que viene detrás se mueve igual» marcado, todas las frases posteriores se desplazan lo mismo: así se corrige una canción de principio a fin y cada frase solo necesita su retoque. «Usar la voz» pone los dos tiempos donde la voz detectada arranca y calla. Se puede escuchar la frase sola, en bucle, a 0,75× o 0,5× sin cambiar el tono, con un tono guía que suena la nota de cada sílaba, y «Ver en el juego desde aquí» abre la tele de verdad con la canción tal como está en el editor, aunque no se haya guardado.
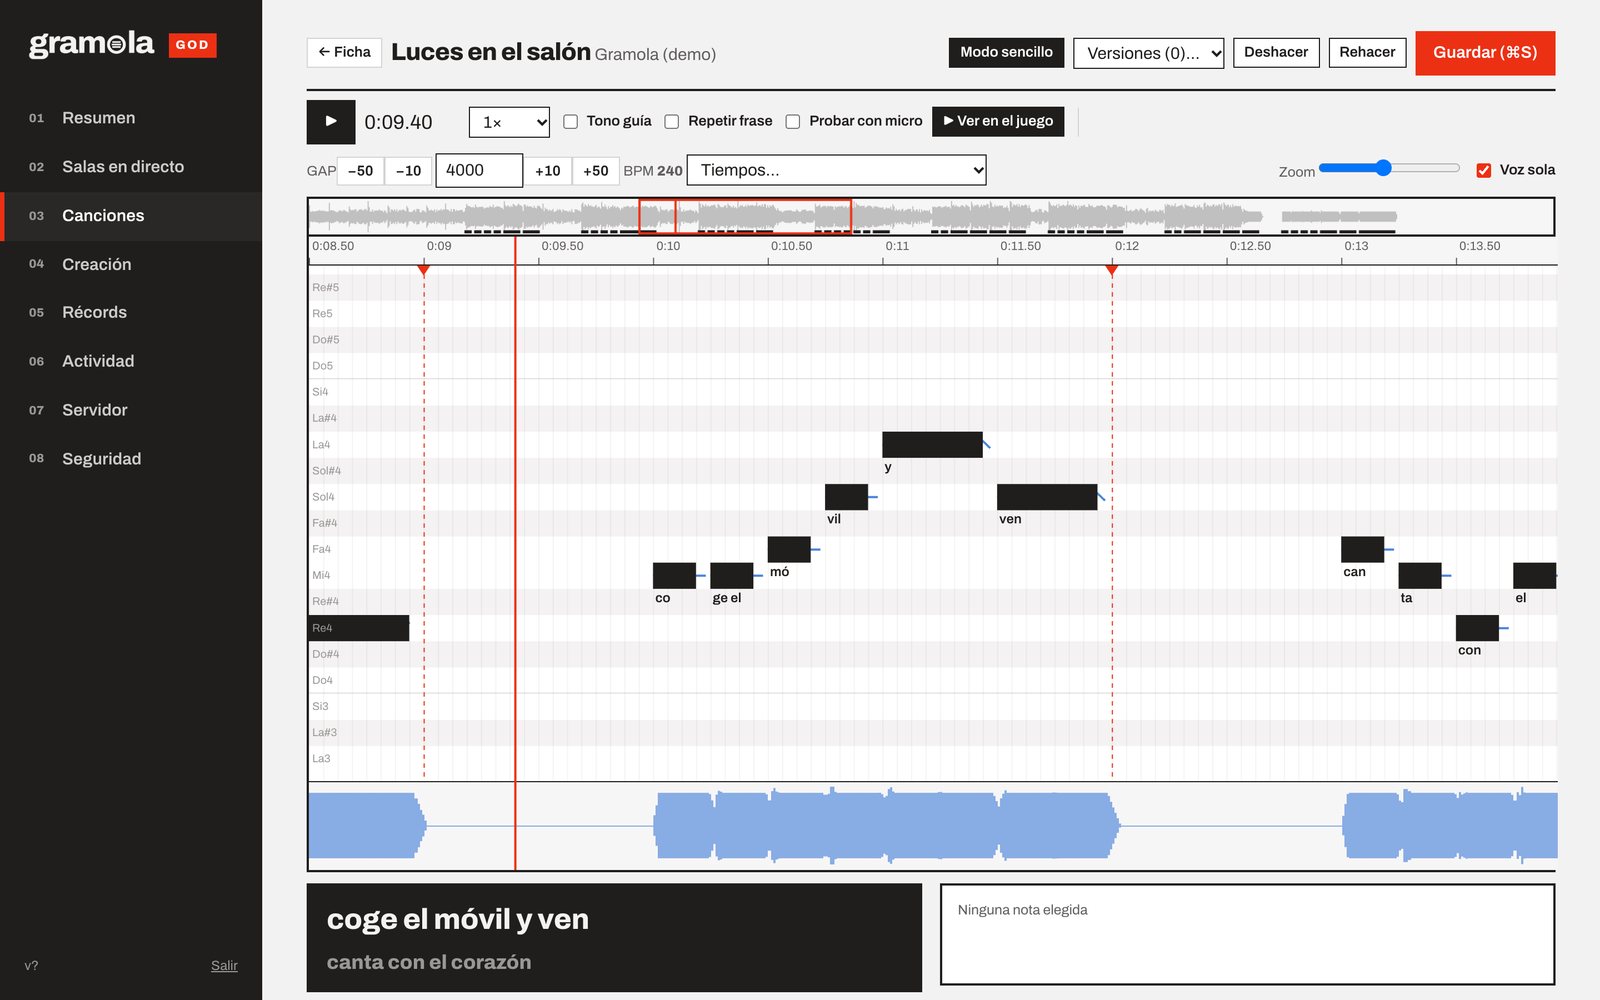
El modo avanzado es la línea de tiempo completa: notas a la altura de su tono, cortes de frase arrastrables, forma de onda de la canción o de la voz sola, curva del tono, minimapa, GAP y BPM, atajos de teclado para partir, unir, mover y cambiar el tipo de nota, y una prueba con el micro del ordenador. Cada guardado deja la versión anterior en el servidor (las 60 últimas) y el .txt se escribe igual que estaba salvo lo que se cambie.
Crear una canción desde cero
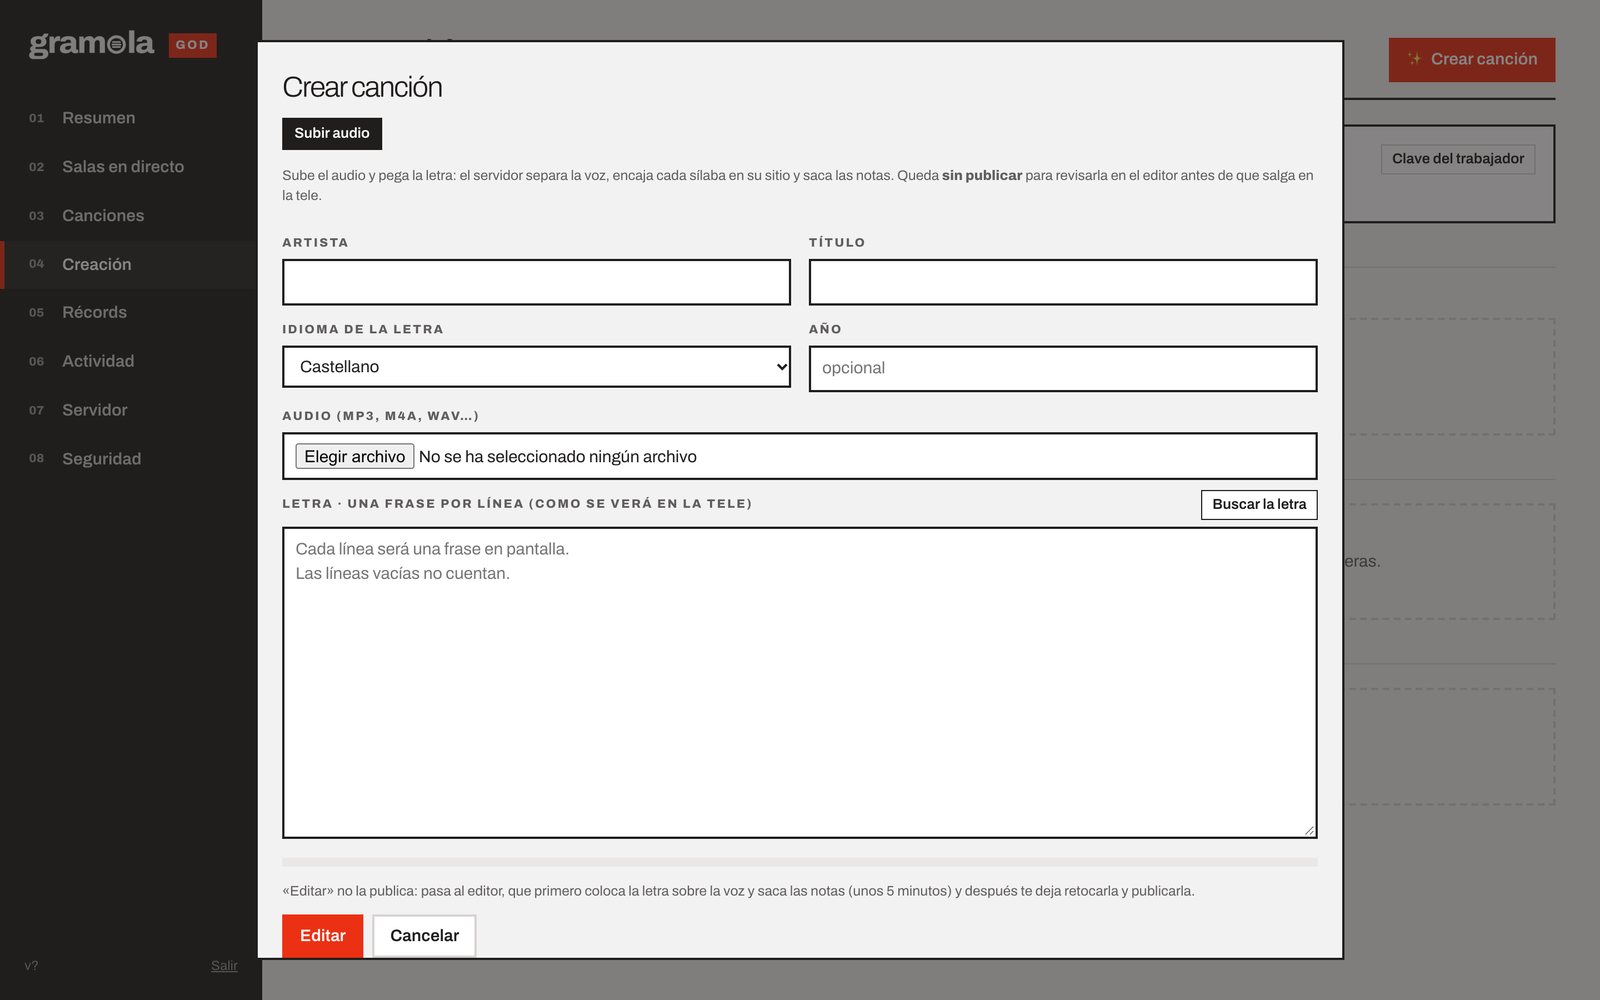
Se puede crear una canción solo con el audio y la letra, una frase por línea. El trabajo va a una cola que atiende un trabajador en Python, un servicio aparte en el mismo servidor con prioridad mínima, que hace lo siguiente:
- Separa la voz de la música con Demucs (htdemucs). Queda
voz.mp3. - Mide el tono de la voz separada cada 10 ms con CREPE (pYIN de reserva). Queda
voz-tono.json. - Parte la voz en tramos por los silencios (un silencio de 0,35 s separa; lo que dura menos de 0,3 s no cuenta) y reconoce qué dice cada tramo, palabra a palabra con tiempos, con faster-whisper. Queda
voz-tramos.json. - Alinea la letra sobre la voz con un alineador forzado multilingüe (wav2vec2). No transcribe: coloca el texto que se le da, y cada letra recibe su instante. Antes, cada línea de la letra se empareja con las palabras reconocidas (en orden, coincidencias largas primero, para que cada estribillo repetido vaya al suyo) y el alineador solo busca cada línea en la zona donde la voz la dice.
- Parte las palabras en sílabas (pyphen, según el idioma) y da a cada sílaba su inicio, su fin y su nota. El fin se alarga mientras suene la voz, para que las notas largas queden enteras; la nota es el tono sostenido, sin el arranque y con los saltos de octava del detector corregidos; una sílaba larga solo se parte en dos notas si la melodía cambia de verdad (más de un semitono durante 0,25 s, medido con una media que ignora el vibrato).
- Escribe el
.txten UltraStar con BPM 400, que da una resolución de 37,5 ms por pulso.
Tarda unos cinco minutos por canción en una CPU normal, con un pico de unos 3 GB de memoria. La canción queda sin publicar, se revisa en el editor y se publica desde allí; sale en la tele marcada como novedad. En una canción de prueba con su .txt hecho a mano, los inicios de sílaba quedaron a una mediana de 26 ms del original, el 82 % a menos de 150 ms, y el 76 % de las notas a ±1 semitono. Un hallazgo curioso: el reconocimiento de voz tiende a adelantar cada palabra al hueco anterior, así que el editor afina el inicio de cada trozo con la curva de tono, buscando el primer instante en que la voz tiene tono de verdad.
Robustez
Algunas cosas que aprendí haciéndolo funcionar en fiestas de verdad:
- El WebSocket solo se acepta desde la propia web (cabecera
Origin), con tope de sockets por IP y de mensajes por segundo por socket; sin eso, cualquier página ajena podría usar los navegadores de sus visitantes para abrir salas. - Hay 6.390 códigos de sala posibles y un tope de 500 salas abiertas a la vez; sin tope, al agotarse los códigos el servidor se quedaba colgado buscando uno libre.
- Una sala sin tele se cierra sola a los 3 minutos y un jugador sin conexión durante 10 minutos deja su color libre.
- Los nombres de jugador se limpian de caracteres invisibles y marcas bidi, y un nombre como
_proto_no toca el prototipo de los objetos de récords. - Hay pruebas del servidor (
npm test) y pruebas de navegador con Playwright para la tele cantando, la reconexión, el reinicio del servidor y el editor.
Si quieres montarlo en casa, el README del repositorio explica cómo arrancarlo (cd server && npm install && npm start) y qué hace falta en el servidor. Para jugar con móviles hace falta HTTPS, porque los navegadores solo dejan usar el micro en páginas seguras. Las canciones las pones tú: usa solo las que tengas derecho a usar.
Repositorio: github.com/nuvolacat/Gramola.link